Поиск по документам компании: RAG без свалки PDF
RAG — это когда нейросеть отвечает не «из головы», а сначала ищет подходящие куски в ваших файлах и уже из них собирает ответ. Вы даёте модели доступ к договорам, регламентам, прайсам и инструкциям — и она отвечает по ним, а не по интернету. Звучит просто, и именно поэтому такие проекты чаще всего ломаются: в поиск закидывают всё, что нашли на общем диске.
Ниже — как мы запускаем такой поиск в компаниях, чтобы он не превратился в свалку из ста PDF, где половина файлов устарела ещё в прошлом году.
Что происходит, когда в поиск кладут «всё»
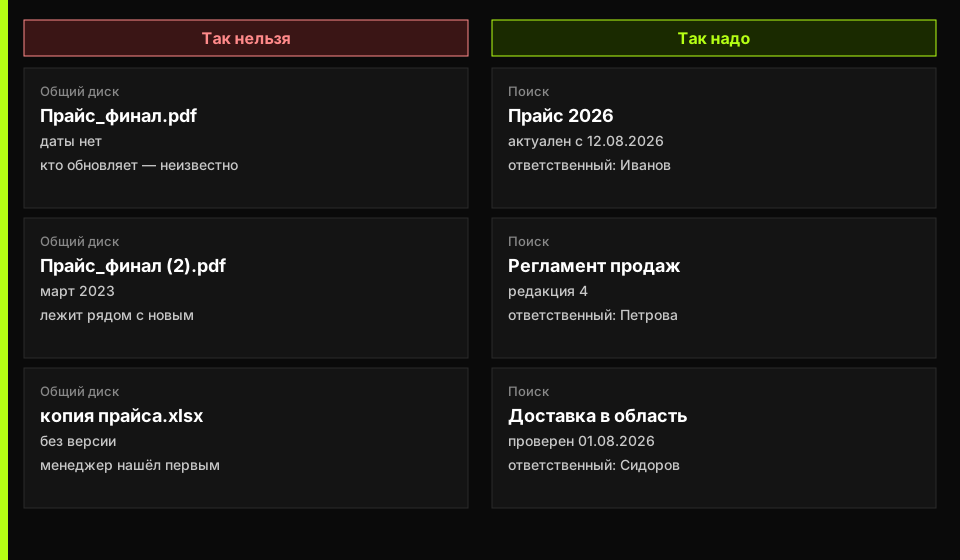
Первое, что мы видим почти в каждом проекте, — в индекс попал старый прайс. Он лежал в папке рядом с новым, никто не помнил, какой из них актуальный, а нейросеть нашла оба и ответила по первому попавшемуся. Дальше менеджер называет клиенту цену прошлого года, и виноватой оказывается «эта ваша нейросеть».
Проблема не в модели. Она отвечает ровно тем, что ей дали. Если в файлах бардак, поиск делает этот бардак быстрым и убедительным: ответ выглядит уверенно, ссылку на источник никто не проверяет, ошибка расходится по команде.
Как готовить документы перед загрузкой
- У каждого файла есть дата: когда документ актуален и до какого числа им можно пользоваться.
- У каждого файла есть ответственный: человек, который его обновляет.
- Персональные данные и документы под NDA в поиск не попадают — ни в каком виде.
- Прайс живёт отдельно: своя история версий и своё правило обновления.
- Старые версии убирают из поиска физически, а не «помечают как неактуальные».
Отдельно про прайсПрайс меняется чаще всего, и цена ошибки сразу выражается в деньгах. Поэтому мы держим его отдельно, обновляем по регламенту и не смешиваем с регламентами и презентациями.
Двадцать вопросов до запуска
До подключения модели просим собрать двадцать реальных вопросов из чатов и звонков. Не выдуманных: «какая скидка от ста штук», «кто согласует договор с новым поставщиком», «сколько идёт доставка в область».
По ним видно, каких документов не хватает: часть ответов живёт только в голове у трёх человек — их сначала надо записать. После запуска те же вопросы — проверка: сравниваем ответ модели с тем, что сказал бы опытный сотрудник.
Что фиксируем по каждому источнику
| Источник | Версия | Кто имеет доступ | Журнал |
|---|---|---|---|
| Прайс | Дата последнего обновления | Продажи, руководитель | Кто и когда менял цену |
| Регламенты | Номер редакции | Вся компания | Кто утвердил редакцию |
| Договоры-шаблоны | Дата утверждения юристом | Продажи, юрист | История правок |
| Инструкции по продукту | Дата проверки | Вся компания | Кто проверял в последний раз |
Таблица не для отчётности. Через месяц нейросеть выдаёт спорный ответ — за минуту находите файл, смотрите версию и понимаете, кто его должен был обновить.
Как выглядит нормальный пилот
Мы не запускаем поиск сразу на всю компанию. Берём один процесс — например, ответы на вопросы клиентов по продукту или подбор условий для менеджера — и работаем только с ним. Один процесс легче наполнить документами и легче проверить.
Где ответ касается денег — цены, скидки, условий оплаты, сроков по договору — решение подтверждает человек. Нейросеть готовит черновик и показывает источник, менеджер соглашается или правит. Как это встроить в ежедневную работу — в разборе про рабочий процесс с GPT.
УборкаРаз в две недели ответственный проходит список источников: убирает то, что устарело, добавляет новое, проверяет прайс. Без этой привычки поиск снова становится свалкой, просто теперь с красивым интерфейсом.
С чего начать у себя
Начните не с выбора модели, а с одного процесса и двадцати вопросов. Мы помогаем разобрать документы, собрать источники, запустить пилот и научить команду им пользоваться. Это наша услуга «ИИ для бизнеса» — напишите нам, обсудим ваш случай.
Частые вопросы
Чем это отличается от обычной нейросети?
Обычная модель отвечает по тому, что запомнила при обучении. Здесь она сначала ищет ответ в ваших файлах и отвечает по ним, со ссылкой на конкретный документ.
Сколько документов нужно для старта?
Для пилота хватает 20–50 файлов по одному процессу. Больше на старте — только хуже: сложнее проверить, откуда пришёл неверный ответ.
Можно ли загрузить туда базу клиентов?
Нет. Персональные данные и документы под NDA в такой поиск не кладём. Для работы с ними нужен отдельный контур и отдельное решение по безопасности.
Что делать, если нейросеть отвечает неправильно?
Смотреть источник. Почти всегда в индексе лежит старый файл или два документа, которые противоречат друг другу. Лечится уборкой, а не сменой модели.
Сколько времени занимает запуск?
Обычно 3–6 недель на пилот по одному процессу: неделя на разбор документов, остальное — на тесты и правки по реальным вопросам.