Стоимость ИИ в проде: где считать токены, а где заявку
Токен — единица текста, за которую провайдер LLM берёт деньги: входящий запрос и ответ модели складываются в счёт. Дешёвый ответ при дорогом лиде — не победа: экономия на API может обернуться потерей заявки или часами работы менеджера.
Ниже — как на пилоте разделить, где считать токены, а где заявку и качество. Старт внедрения — внедрение ИИ без хаоса; качество ответов — как проверить ответы модели.
Где считать токены, а где — заявку
Счёт от провайдера нейросети видно сразу, а стоимость заявки — нет. Компания месяц радуется, что один ответ стоит копейки, и не замечает, что менеджер переписывает за моделью каждое третье письмо. В таблице — какой сценарий чем мерить: где хватит токенов, а где считать CPL, то есть стоимость одной заявки.
| Сценарий | Считаем | Почему |
|---|---|---|
| FAQ на сайте, типовые вопросы | Токены + hit-rate кэша | Объём предсказуем, главное — не переплатить за длинные ответы |
| Скоринг лида на входе | CPL и доля целевых | Ошибка модели дороже лишних токенов |
| Разбор документов и RAG | Токены + время эксперта на проверку | Галлюцинация в цифрах бьёт по доверию |
| Поддержка после продажи | CSAT и время до эскалации | Дешёвый чат, который не решает — минус к NPS |
Лимиты, кэш и эскалация
- Потолок токенов на один диалог — жёстко в конфиге, не «по ощущениям».
- Кэш для повторяющихся FAQ с датой обновления и ручным сбросом при смене прайса.
- Порог эскалации: ключевые слова, неуверенность модели, запрос цены или жалоба.
- Лог диалогов для выборочной проверки — не только для обучения, но и для аудита расхода.
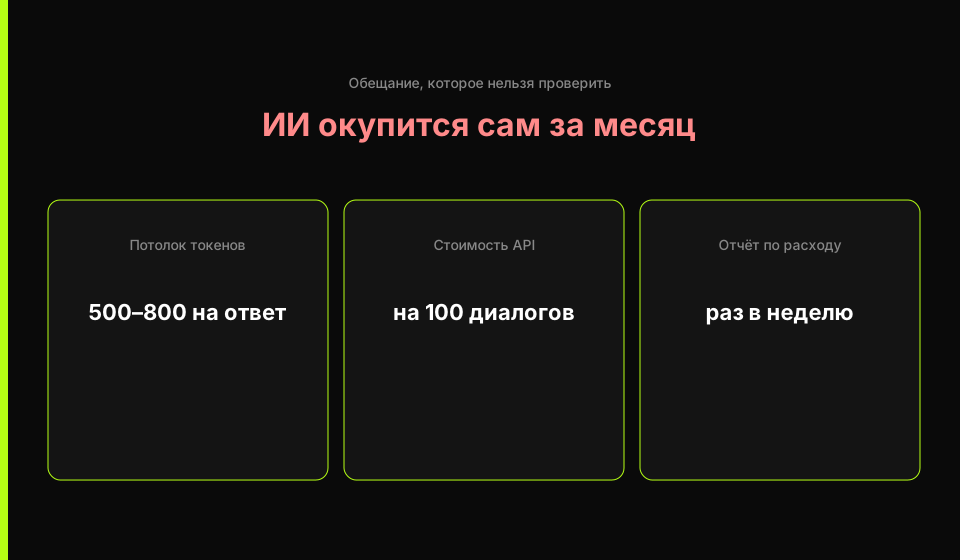
- Еженедельный отчёт: токены, число диалогов, целевые лиды, доля эскалаций.
Порог эскалации — это правило, по которому диалог уходит человеку: клиент спросил цену, пожаловался или модель сама не уверена в ответе. Без такого правила чат-бот дёшево отвечает «уточните вопрос» до тех пор, пока клиент не закроет чат и не позвонит конкуренту. Канал эскалации как раз обрывает этот цикл и отдаёт разговор менеджеру.
Из чего складывается счёт за ИИ
- Входящий запрос: системная инструкция, история диалога и документы, которые модель перечитывает при каждом обращении.
- Ответ модели: короткому вопросу с сайта обычно хватает потолка в 500–800 токенов, разбору договора — заметно больше.
- Повторные попытки: каждый переспрос и каждая перегенерация ответа — это ещё один платный запрос, а не бесплатная правка.
- Работа людей: часы менеджера на исправление ответов и часы разработчика на переписывание инструкции для модели.
Кто отвечает за экономику пилота
KPI пилота: что зафиксировать до масштаба
До подключения второго канала зафиксируйте KPI: среднее время ответа, доля закрытых обращений без человека, CPL из чата, стоимость API на 100 диалогов. Пилот на 30–60 дней с одним сценарием — не «поставили GPT везде», а измеримый участок воронки.
Порядок первого месяца
- Замерить базу до включения нейросети: среднее время ответа, долю обращений, закрытых без человека, и стоимость заявки из этого канала.
- Выбрать один сценарий и один канал — например, типовые вопросы на сайте, а не «поставили ИИ везде».
- Прописать в настройках потолок токенов на диалог и правила, по которым разговор уходит менеджеру.
- Включить кэш для повторяющихся вопросов и назначить, кто сбрасывает его при смене цен и регламентов.
- Раз в неделю сводить один отчёт: расход, число диалогов, целевые заявки, доля эскалаций.
- На тридцатый день сравнить с базой и только тогда решать, подключать ли второй канал.
ПроверкаЕсли счёт за токены падает, а менеджеры тратят больше времени на исправление ответов — экономия мнимая. Сравнивайте с базой до пилота, а не только с тарифом API.
Частые вопросы
Что дороже: токены или потерянный лид?
Один нецелевой ответ модели стоит копейки. Один упущенный горячий лид — тысячи рублей. Считать нужно обе стороны, не только API.
Когда кэш ответов оправдан?
Когда один и тот же вопрос приходит сотни раз в день: FAQ, статусы заказа, типовые условия. Кэш снижает токены, но требует актуализации при смене цен и регламентов.
Какой лимит токенов ставить на диалог?
Зависит от сценария: короткий FAQ — 500–800 токенов на ответ, разбор документа — выше. Главное — жёсткий потолок и эскалация, а не бесконечный чат.
Как связать стоимость ИИ с CPL?
Суммируете расход API за период, делите на число целевых лидов из канала с ботом. Если CPL растёт при падающем счёте за токены — проблема в качестве, не в тарифе модели.