Корпоративная база знаний с ИИ
Корпоративная база знаний с ИИ — это ваши регламенты, инструкции и FAQ в одном поиске: сотрудник задаёт вопрос обычными словами и получает фрагмент из актуального документа, а не десять ссылок в общей папке.
Разбираем порядок работ на примере сервисной компании, где больше двухсот инструкций, а вопросы сотрудников каждый день оседают в кадровой службе и в поддержке. Ниже — что собрать до индексации, как устроен поиск по смыслу, как закрыть документы правами доступа и какие цифры показать руководству после пилота. Смежное: AI-интеграции и разбор архитектуры в статье про поиск по своим документам.
Сколько стоит вопрос, на который никто не находит ответ
Инструкция лежит в общей папке, но сотрудник её не находит: имя файла ничего не говорит, поиск по названию выдаёт три версии одного документа, и человек идёт спрашивать коллегу. На один такой вопрос уходит 15–20 минут, и через месяц он повторяется у следующего новичка.
Инвентаризация документов перед индексом
- Список источников: Confluence, SharePoint, PDF, Notion — с владельцем.
- Удалить или пометить устаревшие версии — иначе бот цитирует прошлогодний регламент.
- Приоритет: документы, по которым чаще всего спрашивают HR и линию поддержки.
- Формат: текстовый слой в PDF, не скан без OCR.
Семантический поиск и chunking
Документы режут на фрагменты (chunking) с перекрытием, каждый фрагмент превращают в embedding — числовой вектор смысла. Запрос сотрудника ищет ближайшие векторы (vector search), retrieval отдаёт top-k фрагментов в модель или в выдачу поиска.
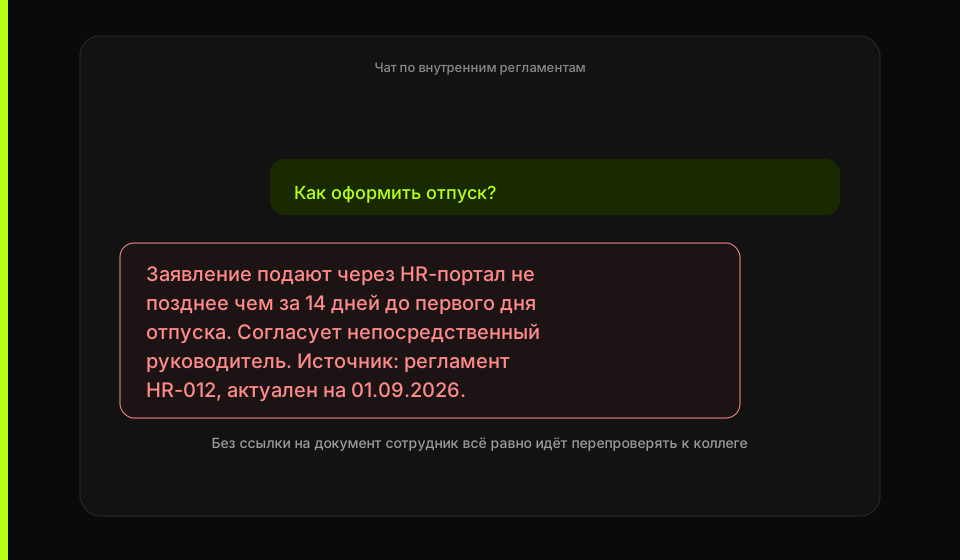
Обычными словами это значит вот что: система ищет не точное слово из заголовка, а близкий по смыслу кусок текста. Такой способ отвечать называют RAG — нейросеть не выдумывает ответ «из головы», а сначала находит фрагменты в ваших документах и пересказывает их, показывая, откуда взяла.
Из чего собирается рабочая база знаний
Отдельная история — вход и права. Единый корпоративный вход (SSO, single sign-on) — это когда сотрудник открывает базу тем же логином, что и рабочую почту, а не заводит ещё один пароль. Тот же логин говорит системе, из какого человек отдела, — по этому признаку и режут индекс.
Права доступа и SSO
- Вход через корпоративный SSO — не отдельный пароль на базу.
- Индекс с меткой отдела: продажи не видят кадровые регламенты.
- Аудит запросов: кто спрашивал что — для compliance.
- Обновление индекса по webhook при смене документа в wiki.
Пилот на две недели: KPI для руководства
| Метрика | До | Цель пилота |
|---|---|---|
| Минуты на поиск ответа | 15–20 | < 3 |
| Повторные вопросы в HR | база | −30% |
| Доля ответов с источником | — | > 90% |
| Эскалации «не нашёл» | — | < 10% |
ФактНе переносите всю wiki в первый релиз: один отдел, один тип документов, измеримый результат — потом масштаб.
Частые вопросы
Чем база знаний с ИИ отличается от обычной wiki?
Семантический поиск находит ответ по смыслу, а не только по точному слову в заголовке. Чат-бот собирает ответ из фрагментов с цитатой источника — если настроен RAG.
Как не допустить утечки данных?
SSO и права по отделам: индекс режется по ролям. Логи без экспорта в публичные модели без DPA. Пилот на одном контуре до масштабирования.
С чего начать, если 200+ PDF?
Инвентаризация: актуальные регламенты, владельцы, частота обновлений. Пилот на 30–50 документов одного отдела. Chunking и embedding — потом чат.
Как показать ROI руководству?
До/после: минуты на поиск ответа, число повторных вопросов в HR/IT, доля обращений первой линии. Пилот 2 недели даёт цифры, не презентацию.